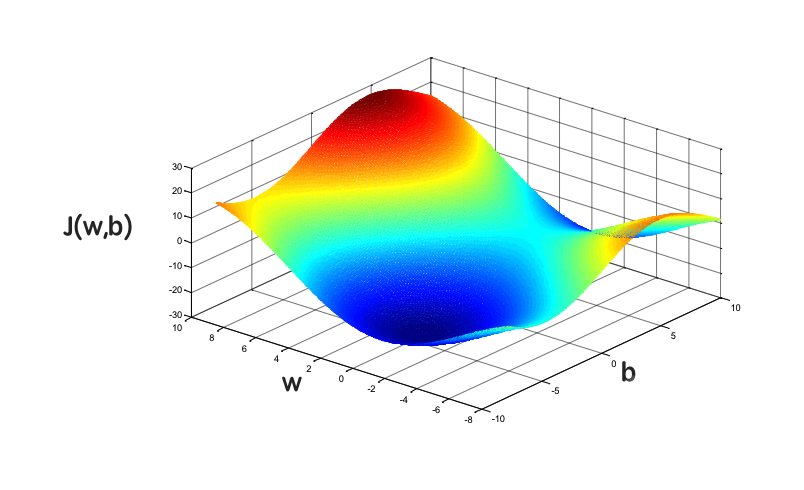
Gradient descent algorithm
Ottimizzatori nel Machine Learning: da Gradient Descent ad Adam
Nel machine learning, e in particolare nell’addestramento delle reti neurali, uno degli aspetti più importanti è il modo in cui il modello aggiorna progressivamente i propri parametri per ridurre l’errore. Questo processo avviene attraverso algoritmi di ottimizzazione, il cui obiettivo è trovare una configurazione dei pesi che minimizzi la funzione di perdita.
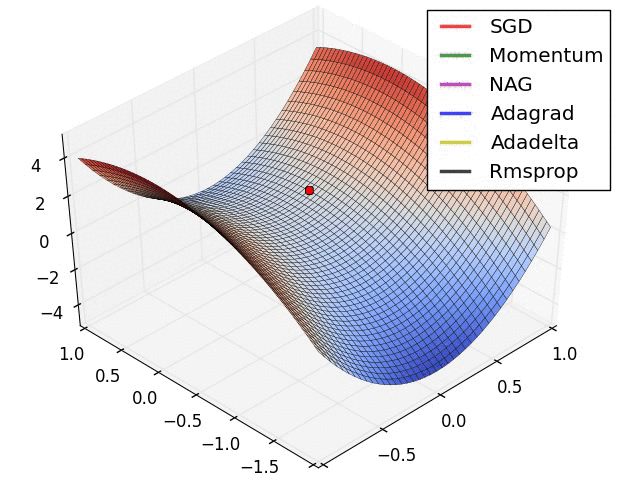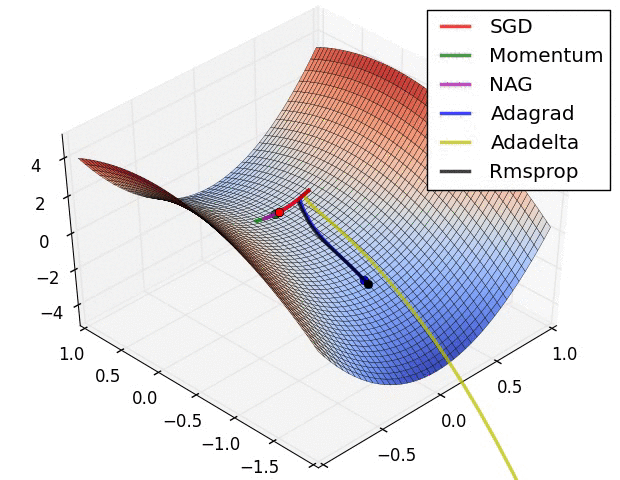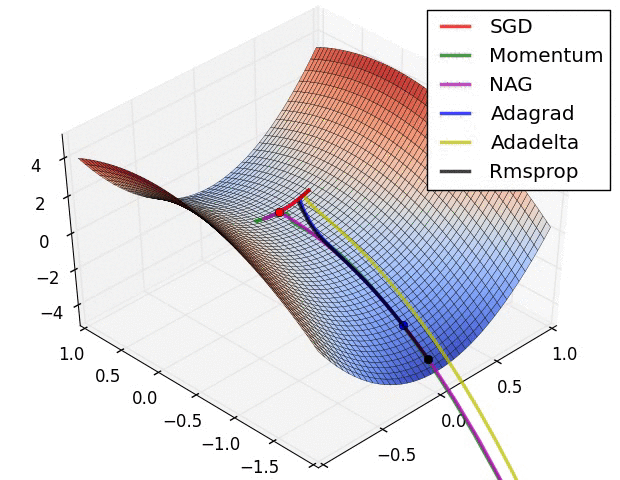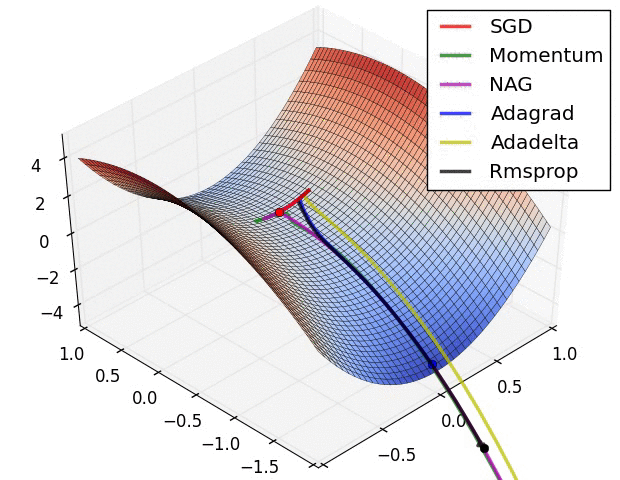
L’algoritmo più semplice e intuitivo è la discesa del gradiente, o Gradient Descent. In questo approccio, il modello calcola la direzione in cui la funzione di errore diminuisce più rapidamente e aggiorna i parametri muovendosi in quella direzione. Un elemento fondamentale è il learning rate, cioè il tasso di apprendimento, che stabilisce quanto grande deve essere ogni aggiornamento.
Un learning rate troppo alto può far saltare il modello oltre il minimo, causando instabilità o oscillazioni. Al contrario, un learning rate troppo basso rende l’apprendimento molto lento e può richiedere un numero elevato di iterazioni prima di ottenere risultati soddisfacenti. Nella forma base della discesa del gradiente, il learning rate viene scelto all’inizio e rimane costante durante tutto l’addestramento.
Tuttavia, nei problemi reali, un tasso di apprendimento fisso non è sempre la scelta migliore. Per questo motivo sono stati sviluppati ottimizzatori più avanzati, capaci di adattarsi meglio alla forma della funzione di perdita e di accelerare la convergenza.
Momentum: dare inerzia alla discesa del gradiente
Uno dei primi miglioramenti introdotti rispetto alla discesa del gradiente tradizionale è il Momentum. L’idea è semplice: invece di aggiornare i parametri considerando solo il gradiente corrente, si tiene conto anche della direzione seguita nei passi precedenti.
In pratica, il Momentum aggiunge una frazione del movimento precedente al movimento attuale. Questo permette all’algoritmo di acquisire velocità nelle direzioni corrette e di ridurre le oscillazioni nelle direzioni meno utili.
Immaginiamo di far rotolare una pallina lungo una valle. Se il terreno presenta curve e irregolarità, la pallina non cambia direzione bruscamente a ogni piccolo ostacolo, ma mantiene una certa inerzia. Allo stesso modo, il Momentum aiuta l’ottimizzatore a procedere con maggiore stabilità verso il minimo.
Il valore del coefficiente di momentum è generalmente compreso tra 0 e 1. Un valore basso rende l’effetto più debole, mentre un valore alto aumenta l’influenza dei passi precedenti. Nelle prime fasi dell’addestramento può essere utile mantenere un momentum contenuto, perché gradienti molto grandi potrebbero portare a movimenti eccessivi. In una fase più avanzata, quando i gradienti diventano più regolari, un momentum maggiore può accelerare la convergenza.
Il limite principale del Momentum è che, quando il modello si avvicina al minimo, l’inerzia accumulata può essere ancora elevata. Questo può portare l’algoritmo a superare il punto ottimale, oscillando attorno al minimo invece di stabilizzarsi rapidamente.
Nesterov Accelerated Gradient: anticipare la correzione
Il Nesterov Accelerated Gradient, spesso abbreviato in NAG, nasce per migliorare il comportamento del Momentum nelle vicinanze del minimo.
Nel Momentum classico, l’algoritmo calcola prima il gradiente nella posizione corrente e poi applica un aggiornamento influenzato dalla velocità accumulata. Nesterov inverte parzialmente questa logica: prima effettua una sorta di “sguardo in avanti”, stimando dove porterà il momentum accumulato, e solo dopo calcola il gradiente in quel punto anticipato.
Questa differenza può sembrare piccola, ma ha effetti pratici importanti. L’algoritmo riesce a correggere prima la traiettoria, rallentando quando si sta avvicinando al minimo e riducendo il rischio di superarlo. Per questo motivo, NAG può garantire una convergenza più stabile e spesso più rapida rispetto al Momentum tradizionale.
AdaGrad: un learning rate diverso per ogni parametro
Un altro passo importante nell’evoluzione degli ottimizzatori è AdaGrad, abbreviazione di Adaptive Gradient. A differenza della discesa del gradiente classica, AdaGrad non utilizza un unico learning rate globale per tutti i parametri. Ogni parametro ha invece un proprio tasso di apprendimento, che viene adattato in base alla frequenza e all’intensità con cui quel parametro viene aggiornato.
I parametri che ricevono aggiornamenti frequenti vengono modificati con passi più piccoli, mentre quelli che compaiono più raramente ricevono aggiornamenti più grandi. Questo rende AdaGrad particolarmente utile nei contesti con dati sparsi, come il Natural Language Processing, i sistemi di raccomandazione o alcune applicazioni di riconoscimento delle immagini.
Uno dei vantaggi principali di AdaGrad è che riduce la necessità di scegliere manualmente un learning rate perfetto. L’algoritmo adatta automaticamente il passo di aggiornamento per ciascun parametro.
Il suo limite, però, è che il learning rate tende a diminuire continuamente nel tempo. Poiché AdaGrad accumula l’informazione dei gradienti passati, il denominatore usato per calcolare l’aggiornamento cresce progressivamente. Di conseguenza, gli aggiornamenti diventano sempre più piccoli. Dopo un certo numero di iterazioni, il learning rate può diventare così basso da bloccare quasi completamente l’apprendimento.
AdaDelta e RMSprop: evitare che l’apprendimento si fermi
AdaDelta nasce proprio per superare il problema della riduzione monotona del learning rate tipica di AdaGrad. Invece di accumulare tutti i gradienti passati dall’inizio dell’addestramento, AdaDelta considera solo una finestra mobile della storia recente.
Questo significa che l’algoritmo non rimane vincolato da tutto ciò che è accaduto nelle prime fasi dell’apprendimento, ma si adatta in modo più dinamico alla situazione corrente. In questo modo, il learning rate non tende necessariamente a ridursi fino a valori trascurabili e il modello può continuare ad apprendere anche dopo molte iterazioni.
Un approccio molto simile è RMSprop, che utilizza una media mobile dei quadrati dei gradienti per adattare il learning rate. Anche RMSprop è stato progettato per mantenere l’apprendimento stabile ed evitare che gli aggiornamenti diventino troppo piccoli troppo presto.
Questi metodi sono particolarmente efficaci quando la funzione di perdita presenta superfici complesse, con curvature differenti lungo le varie direzioni.
Adam: combinare Momentum e adattività
Uno degli ottimizzatori più utilizzati nelle reti neurali moderne è Adam, acronimo di Adaptive Moment Estimation. Adam combina due idee fondamentali: il Momentum e l’adattamento del learning rate per ciascun parametro.
Da un lato, Adam mantiene una stima della media dei gradienti, cioè una forma di momentum. Questo permette all’algoritmo di muoversi con maggiore stabilità lungo le direzioni rilevanti. Dall’altro lato, mantiene anche una stima della varianza dei gradienti, adattando il learning rate in modo diverso per ogni parametro.
In questo senso, Adam può essere visto come un’evoluzione di metodi come AdaGrad, RMSprop e Momentum. È spesso apprezzato perché funziona bene in molti scenari senza richiedere una regolazione eccessiva degli iperparametri.
Naturalmente, Adam non è sempre la soluzione migliore in assoluto, ma rappresenta una scelta molto solida come punto di partenza per l’addestramento di reti neurali profonde.
Conclusione
La scelta dell’ottimizzatore ha un impatto significativo sulla velocità e sulla qualità dell’addestramento di un modello di machine learning.
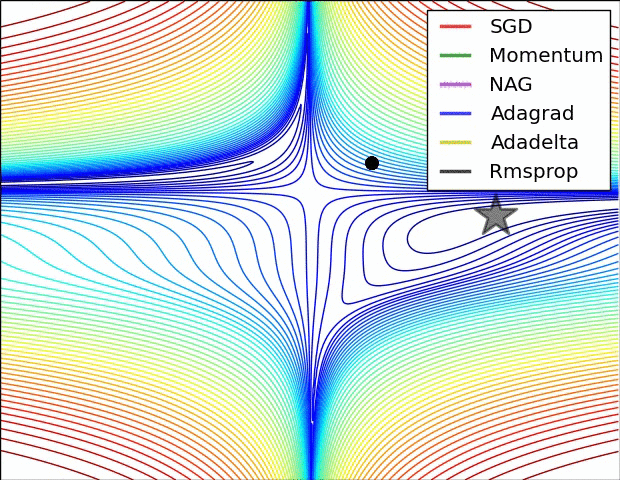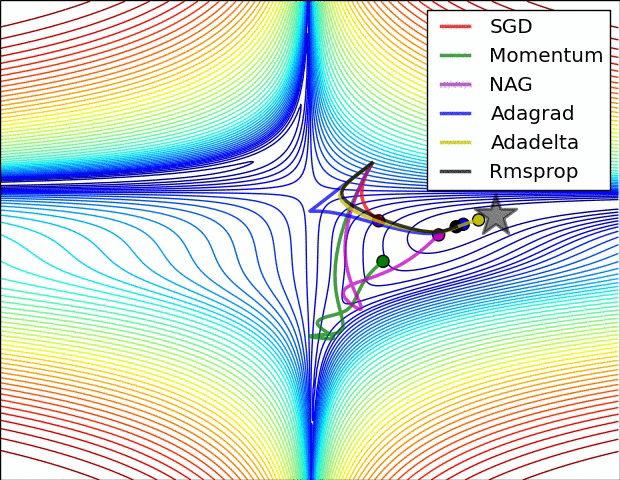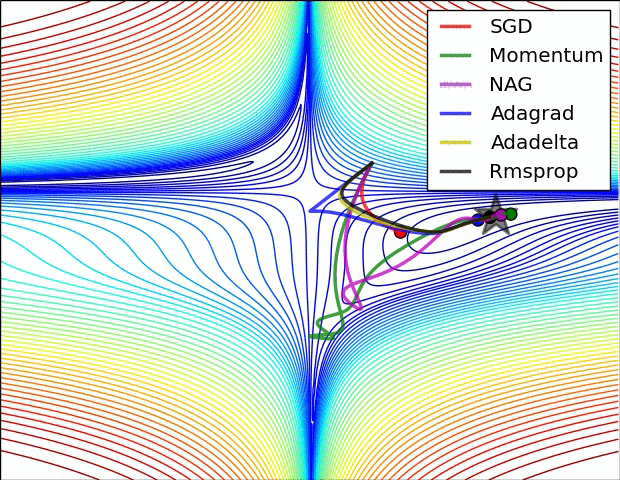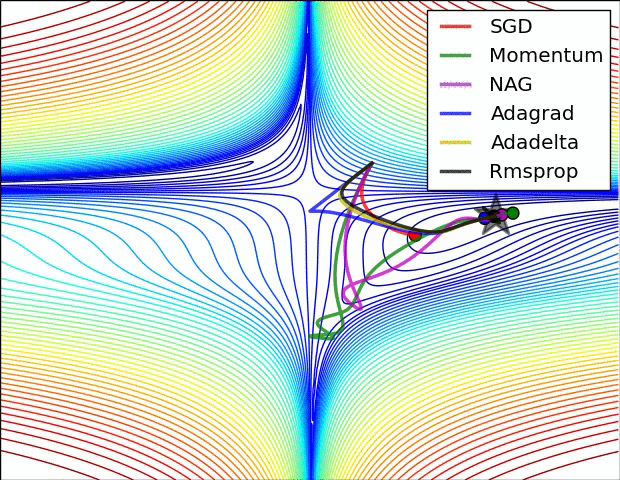
La discesa del gradiente classica è semplice e intuitiva, ma può essere lenta o instabile se il learning rate non è scelto con attenzione. Il Momentum migliora la stabilità introducendo memoria del movimento precedente. Nesterov rende questa memoria più intelligente, anticipando la correzione della traiettoria. AdaGrad introduce learning rate specifici per ciascun parametro, risultando utile con dati sparsi, ma rischia di ridurre troppo rapidamente la capacità di apprendimento. AdaDelta e RMSprop mitigano questo problema usando informazioni recenti invece dell’intera storia dei gradienti. Adam, infine, combina momentum e adattività, diventando uno degli algoritmi più diffusi nell’addestramento delle reti neurali.
In sintesi, gli ottimizzatori moderni non si limitano a “scendere” lungo la funzione di errore, ma cercano di farlo in modo più intelligente, adattandosi alla geometria del problema e migliorando la velocità di convergenza.
Comments