
Rappresentazione grafica dei dati con Python – Matplotlib: Seconda Parte
Nel precedente articolo ho parlato di matplotlib per disegnare delle curve generiche, in questo farò vedere come disegnare grafici a dispersione, istogrammi e serie temporali.
| Vi ricordo che per gli esempi successivi userò Jupyter notebook, pertanto se non sapete di cosa si tratta vi invito a dare un occhio a questo articolo. |
Creazione del progetto Jupyter notebook
Aprite una shell, create una nuova directory e lanciate il comando jupyter notebook
mkdir ESEMPIO
cd ESEMPIO/
jupyter notebook
si aprirà un finestra del tuo browser
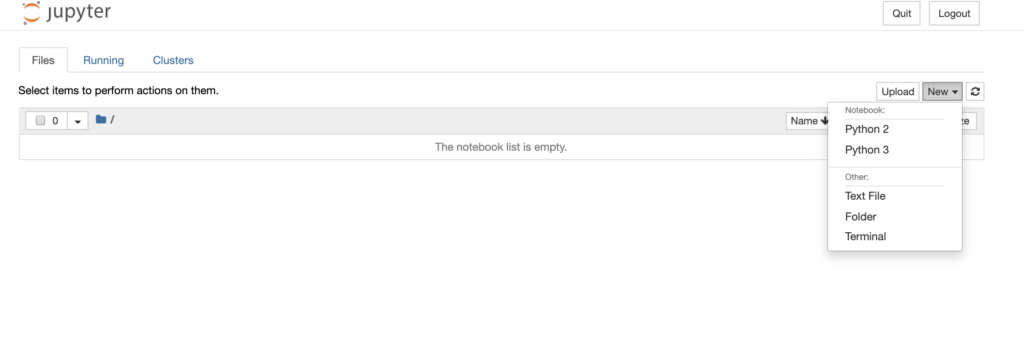
a questo punto selezionate l’interprete Python 3 per inizializzare l’ambiente

Grafici a dispersione
per prima cosa importiamo le librerie necessarie:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Per generare i punti nello spazio di dispersione usiamo numpy.
#Generiamo dei punti casuali
randomPoints=np.random.randn(100,2);
| np.random.randn restituisce i campioni nello spazio di dispersione.
Se vengono forniti argomenti positivi interi, randn genera un array (d0, d1, …, dn), riempito con float casuali campionati secondo una distribuzione “normale” (gaussiana) di media 0 e varianza 1. Se non viene fornito alcun argomento verrà restituito un singolo campione float casuale della distribuzione standard . |
L’istruzione precedente genererà 100 punti in modo casuale. Il risultato sarà qualcosa del genere:
array([[-0.28393081,  1.69444015],
       [ 1.18710769,  0.75168393],
       [-1.08797599,  0.16593107],
       [ 0.34718794,  1.50584947],
       [ 0.59907203,  0.34574815],
       [-1.17150305,  1.32782198],
       [-0.66961386,  0.13941936],
       [ 0.96038988, -0.04362326],
       [-0.42828503, -1.35202516],
       [-0.57520301, -0.5182515 ]])
A questo punto possiamo creare il dataframe che utilizzeremo come parametro di pyplot matplotlib
df = pd.DataFrame(randomPoints,columns=['x', 'y'])
e stampare il grafico di dispersione
plt.plot(df['x'],df['y'],'.')

Esempio completo

Se volessimo rappresentare punti più evidenti potremmo usare l’opzione di stampa “o” anziché “.”
plt.plot(df['x'],df['y'],'o')

altre opzioni possono consentirci di creare grafici più significativi, definendo la grandezza dei punti ed il colore, ma per farlo dovremo utilizzare la funzione scatter al posto di plot.
N.B Per il nostro esempio utilizzeremo dei dati casuali anche per i colori e per la grandezza dei punti;
colore_casuale=np.random.randn(100)
r_casuale_punto=1000*np.random.randn(100)
plt.scatter(df['x'],df['y'],s=r_casuale_punto,alpha=0.6,c=colore_casuale)
Comments